Experimento técnico · ChacharApp en iOS
Correr modelos de IA en tu móvil es posible
Whisper turbo transcribiendo en local, en un iPhone, sin que el audio salga del dispositivo. Se puede hacer pero, ¿a qué precio?
He probado el modelo en el móvil y funciona. Otra cosa es que funcione como tú quieres.
Antes de nada, contexto. Esto ya lo hice para el Mac: ChacharApp, un dictado en el que mantienes una tecla, hablas y aparece el texto. Me inspiré en Wispr Flow, pero con una condición: todo en local, sin pagar y sin exponer mis datos. ¿Que ya existe el botón del micrófono? Quien lo haya probado sabe que se equivoca, que no conoce el vocabulario de tu proyecto, y que si dices «el coche es rojo… no, no, verde», te lo transcribe todo, cuando tu solamente quieres decir: «el coche es verde». La herramienta nace justo para arreglar tanto este problema como el de añadir palabras a la jerga de tu proyecto.
Así que la idea era llevarlo al móvil. Sobre el papel cuadra: el modelo pesa unos 620 megas y un iPhone tiene 6 GB de RAM. Y un caso de uso de ejemplo: vas en el coche, quieres contestar un WhatsApp y lo único que quieres es dictar.
La carga del modelo de 626 megas tardaba del orden de minutos. Imaginaos que vais a enviar un mensaje y tenéis que esperar minutos para empezar. Bueno, al menos solo se pasa la primera vez que se carga, porque iOS tiene la capacidad de cachear… aunque se añade una fricción extra: cada vez que se apaga el móvil, o cada vez que se actualiza la app, toca volver a cargar el modelo. Estamos perjudicando un punto fundamental… la disponibilidad.
Por no hablar del consumo de batería que tiene esto: coges el móvil y empiezas a notar que está súper caliente y que la batería se degrada de forma drástica. Porque uno piensa en que el MacBook tiene una batería increíble y no tienes fricción cuando estás trabajando, cuando tienes el equipo conectado. Pero el móvil, el móvil se creó para estar desconectado: el coste que tiene tener este modelo encendido es altísimo…
Y luego el último problema. En iOS no existe algo que se denomina demonios, que son estos procesos en segundo plano que existen para siempre, si uno no los suspende intencionalmente… especialmente si se llevan gran parte de la memoria RAM. Tú cuando abres el Lightroom puedes ocupar, gastar mucha memoria RAM. Pero si tú abandonas esa aplicación y te vas a Instagram, Lightroom no tiene derecho a gastar tantos recursos de RAM. Y es lógico, es un buen diseño, pero ese diseño perjudica drásticamente al uso de un dictado que siempre debe estar disponible. De hecho, es lo que hace Wispr Flow en iOS: te abre su app un momento y vuelves corriendo a WhatsApp, para recalentar el modelo. Un truco, no una solución.
En resumen: si alguna vez os preguntáis por qué el dictado del iPhone no es tan bueno, es porque no puede gastar tantos recursos. Un dictado de calidad supondría deteriorar el resto de capacidades del móvil. En este caso el trade-off es usar el cloud, que tampoco sale gratis: pagas, dependes de la conexión y expones tus datos.
Los trade-offs #s1
Los tres problemas de arriba, puestos en una imagen:
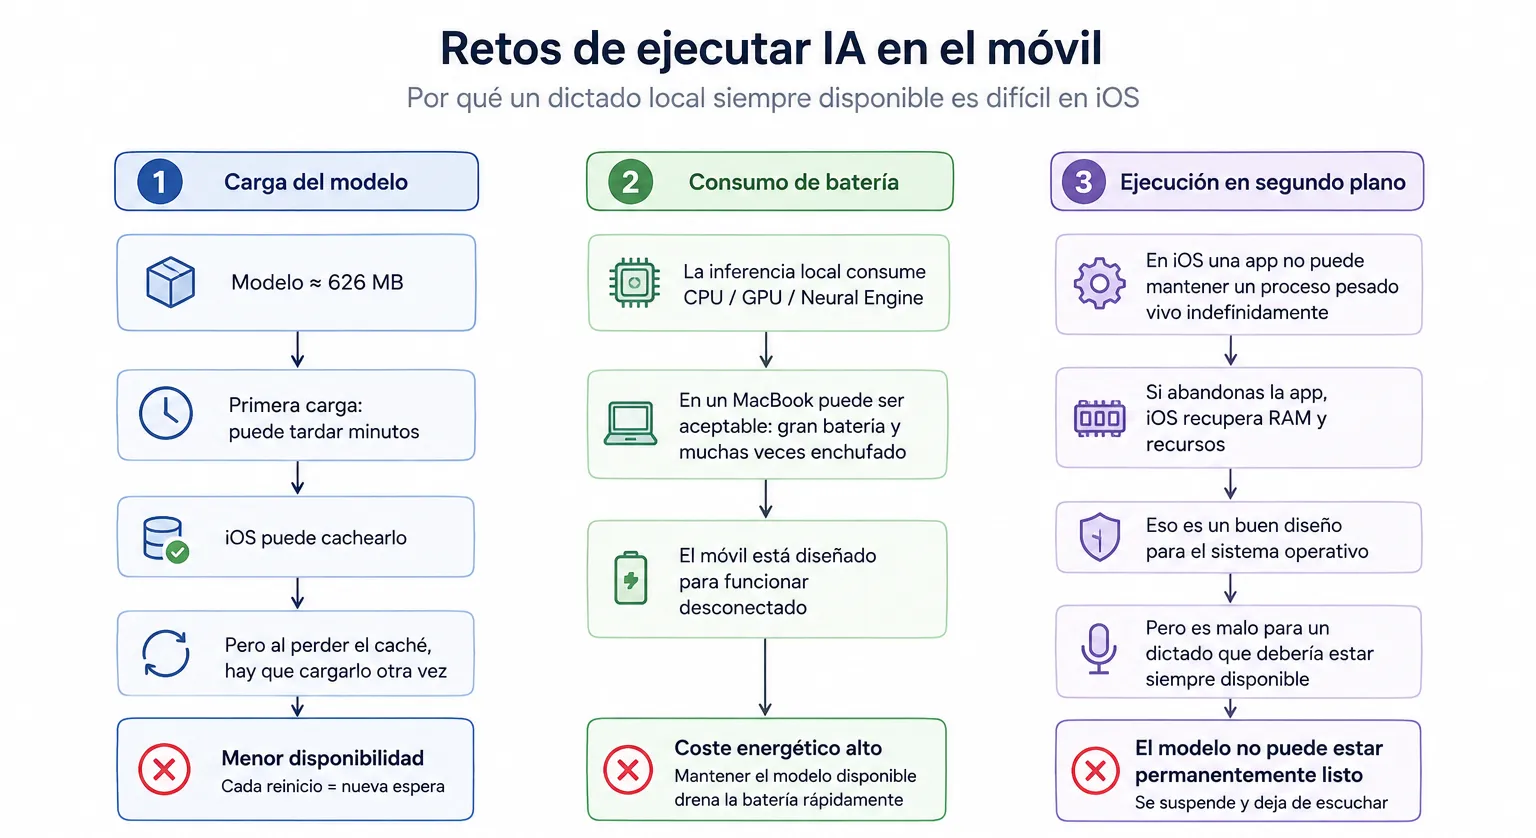
- Carga del modelo: 626 megas que pagas en minutos la primera vez, y otra vez cada vez que se pierde la caché. Cada reinicio, una nueva espera.
- Batería: la inferencia local tira de CPU, GPU y Neural Engine. En un MacBook te lo puedes permitir; en un móvil que vive desenchufado, no.
- Segundo plano: una app de terceros no puede mantener un proceso pesado vivo para siempre. iOS le quita la RAM en cuanto te vas, y el modelo deja de estar listo.
La explicación técnica #s2
Lo de arriba es la versión corta. Los datos que hay detrás, punto por punto:
- Carga inicial: medido, y con una salvedad. La primera carga del turbo (626 MB) tardaba minutos, con un pico de más de 3,2 GB de memoria y riesgo de jetsam; las cargas «calientes» seguían siendo de decenas de segundos. Ojo a un detalle: parte de ese coste era artefacto de desarrollo, porque cada rebuild invalida la caché de compilación del ANE y pagábamos la recompilación una y otra vez. En producción, un usuario la pagaría una vez por actualización de la app. Pero incluso descontando eso, las decenas de segundos de carga caliente ya rompen la sensación de dictado instantáneo.
- Batería: el consumo sí se incrementa. Tirar del ANE para la inferencia y tener el micro caliente (con el punto naranja encendido) toda la sesión se nota: el móvil se pone súper caliente y la batería se degrada de forma drástica. Lo que no tenemos todavía es una cifra exacta de cuánto; la medición fina queda pendiente.
- Mantener el modelo residente: la causa raíz. En iOS no existen demonios en segundo plano, cada proceso tiene un techo de jetsam (por eso un M1 con 8 GB iba excelente y un 14 Pro Max con 6 GB no: el Mac tiene swap, memoria comprimida y ningún tope por proceso), y la captura de audio solo puede arrancar en primer plano. Lo revelador: el footprint residente era de solo unos 90 MB (pesos mapeados). El problema nunca fue tener el modelo en memoria, sino que iOS no permite a una app de terceros ser la dueña de un modelo siempre listo. El único modelo residente en iOS es el del propio sistema (Speech): por eso el dictado de Apple es instantáneo y el nuestro no podía serlo. Y ese lo descartamos por calidad, con razón.
- El uso es distinto. En el Mac, ChacharApp es un proceso de barra de menús siempre vivo; en el iPhone es una app que iOS duerme cuando no la miras. Wispr Flow eligió el formato de app, que es justo lo que Chachar no quiere ser.